AI 个人博客概述和架构设计 —— 个人博客开发日志 01
自从上次技术栈更新已经过了两年,为了添加 AI 功能,以及承载未来复杂的需求,还有为了测试和学习更新的技术栈,决定对博客的技术栈进行更新。
针对个人博客的开发,我会通过多篇文章逐步讲解;本文作为开篇,先把当前博客的整体情况和主要架构设计理清。
开源模板仓库:https://github.com/RJiazhen/canvas-ai
博客介绍
和之前的 VitePress 架构的博客不同,现在的博客从纯静态网页升级成了以 Nuxt.js 为主要框架的 SSR 内容站点。脱离静态站点框架的限制后,现在可以直接借助 SSR 框架本身做各种能力扩展。
比如,此次更新就增加了 AI 能力和想法页,其中的 AI 能力包括让 AI 总结当前页面内容,以及查找并汇总博客中的特定内容。
AI 功能演示:
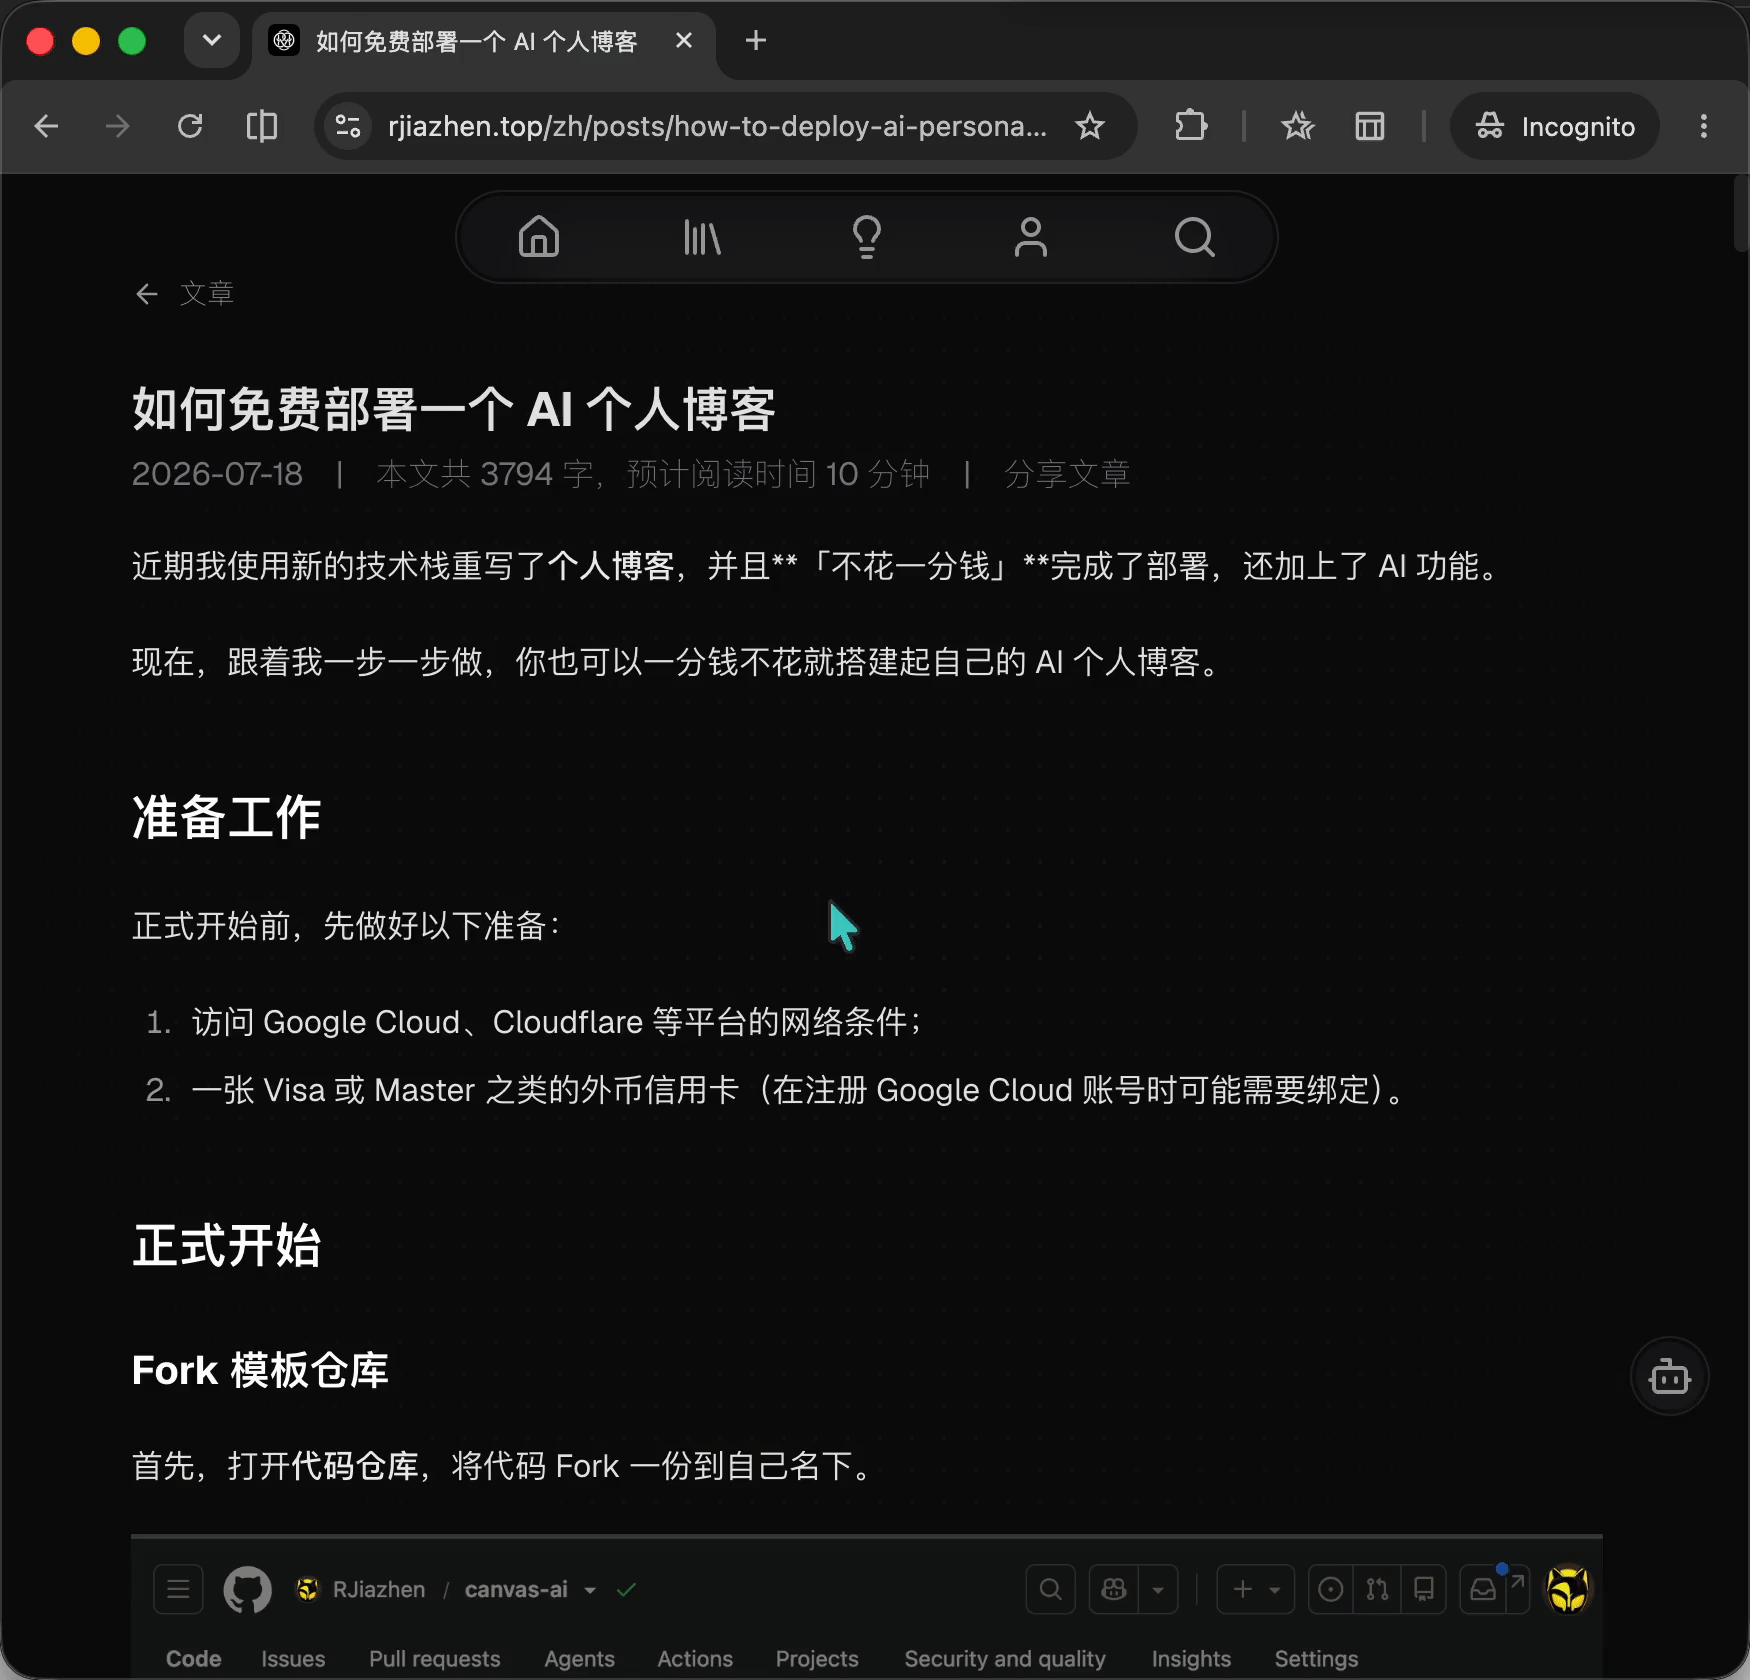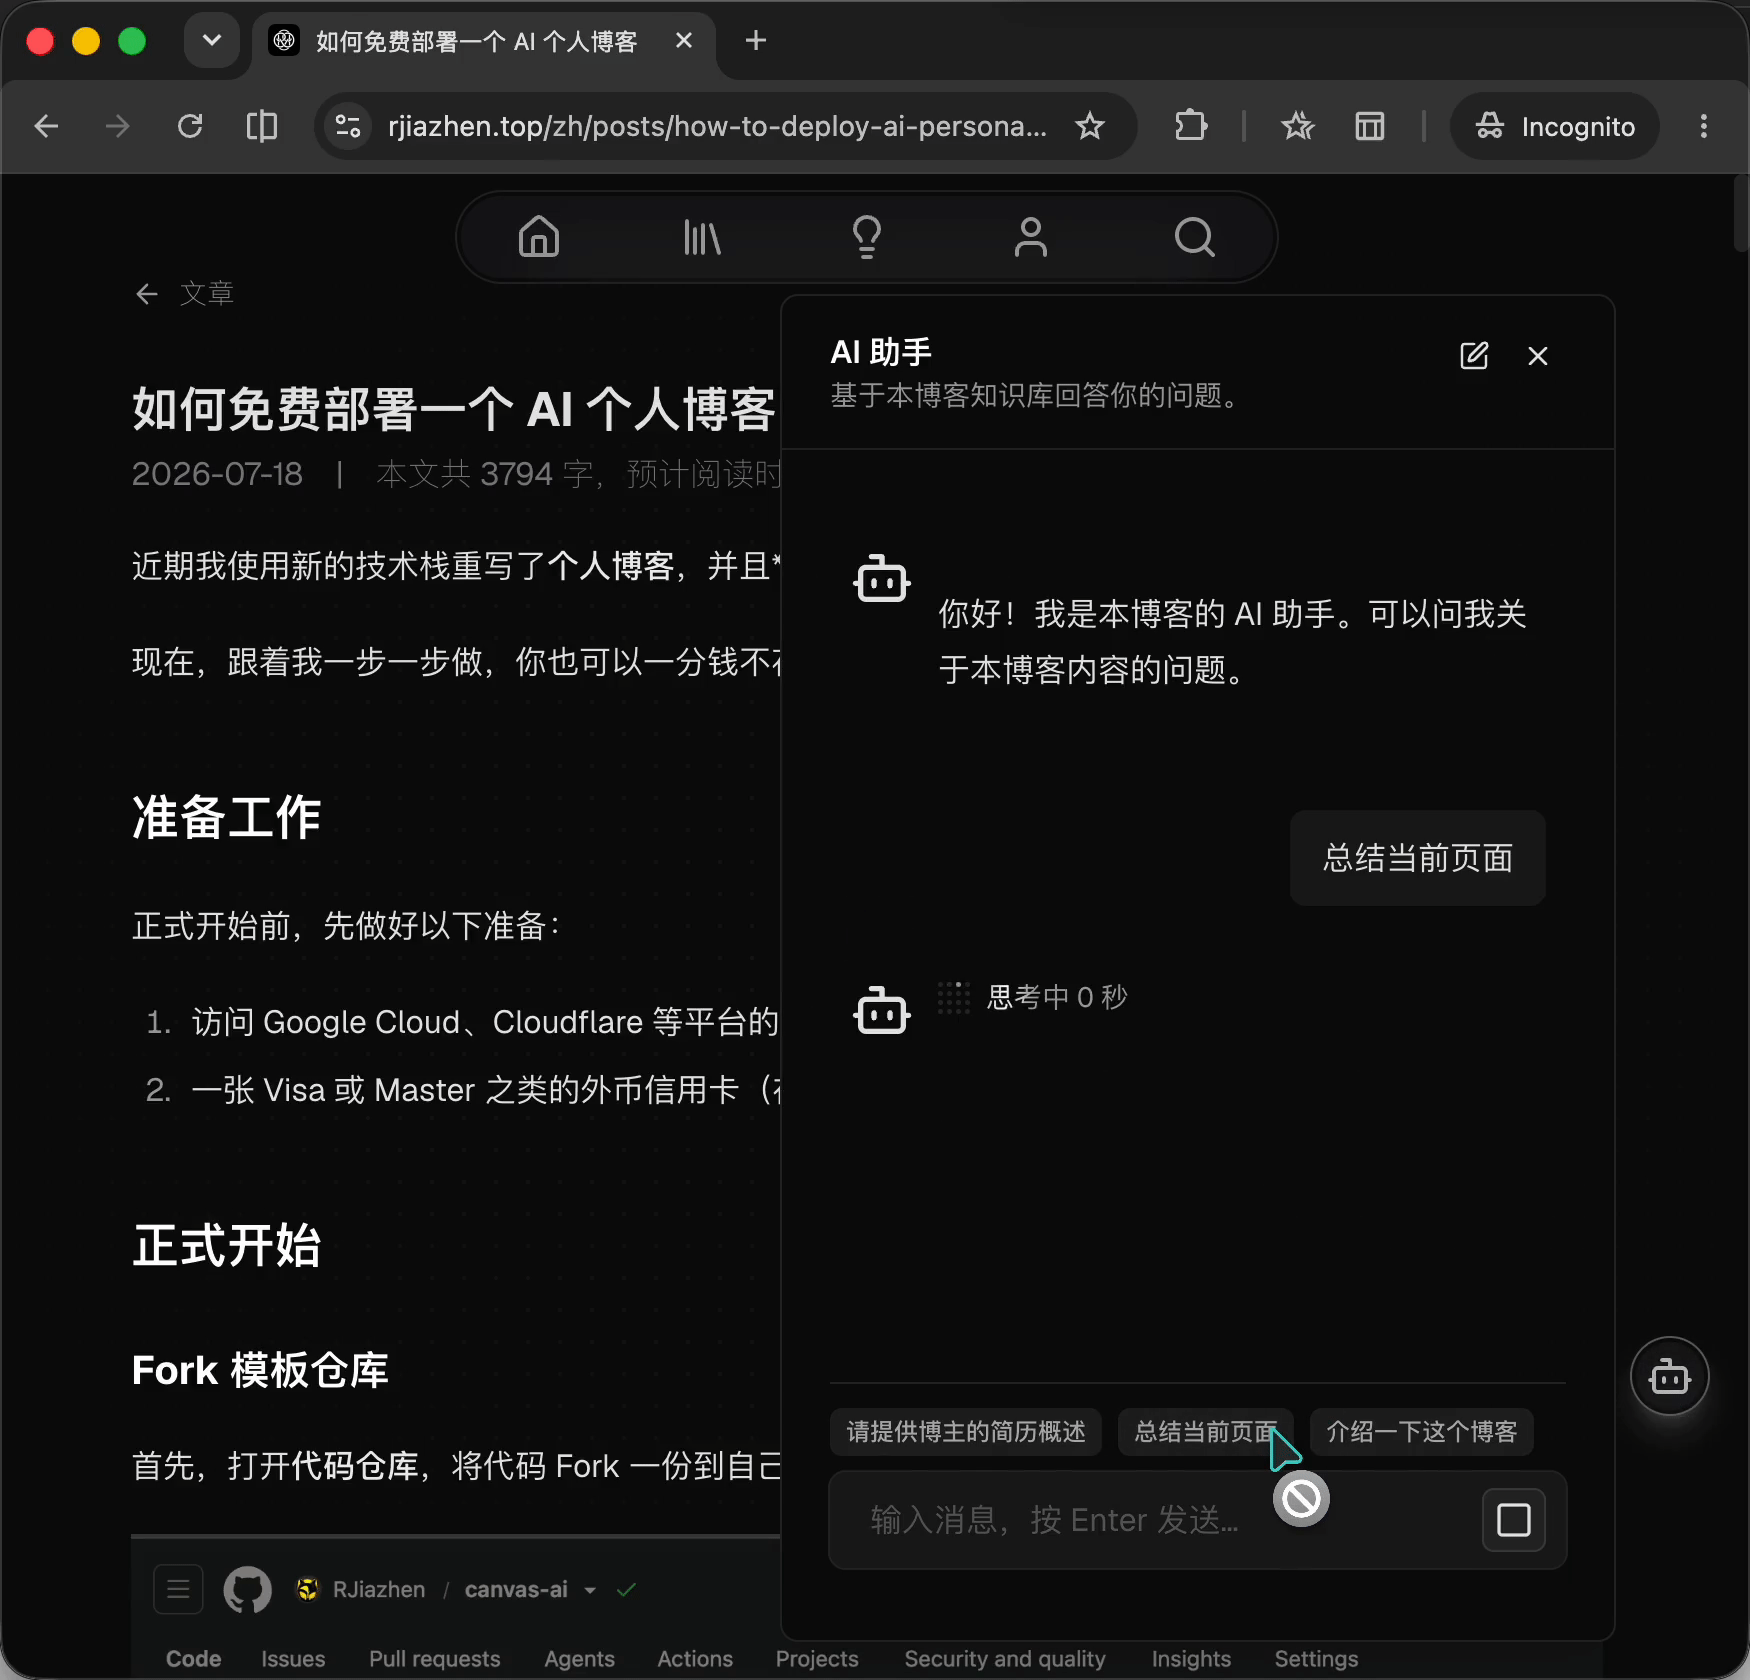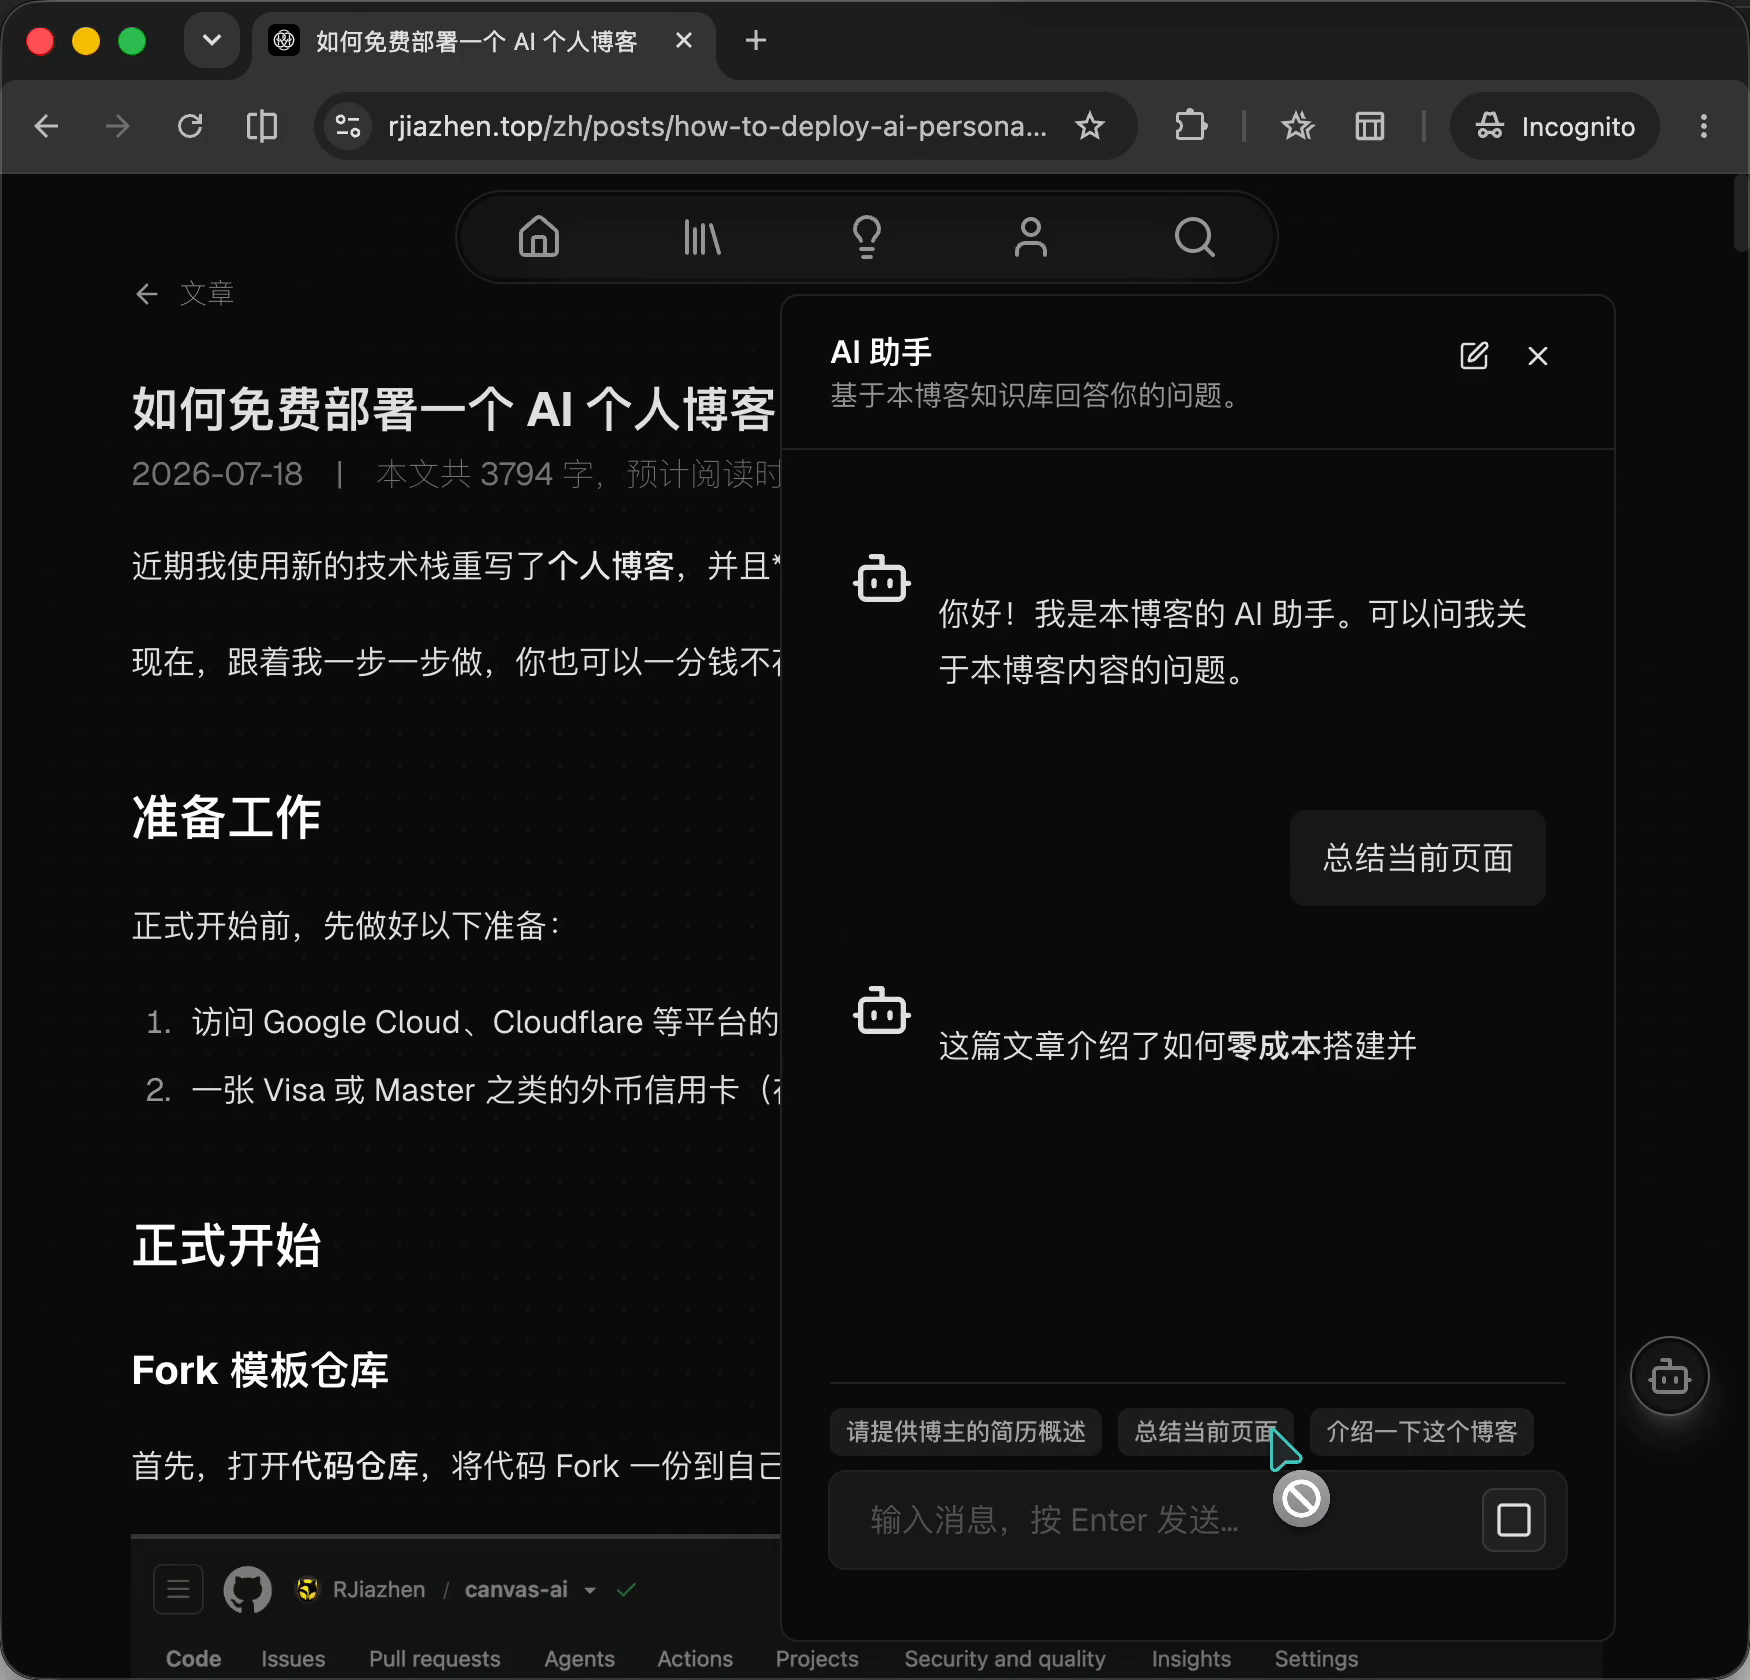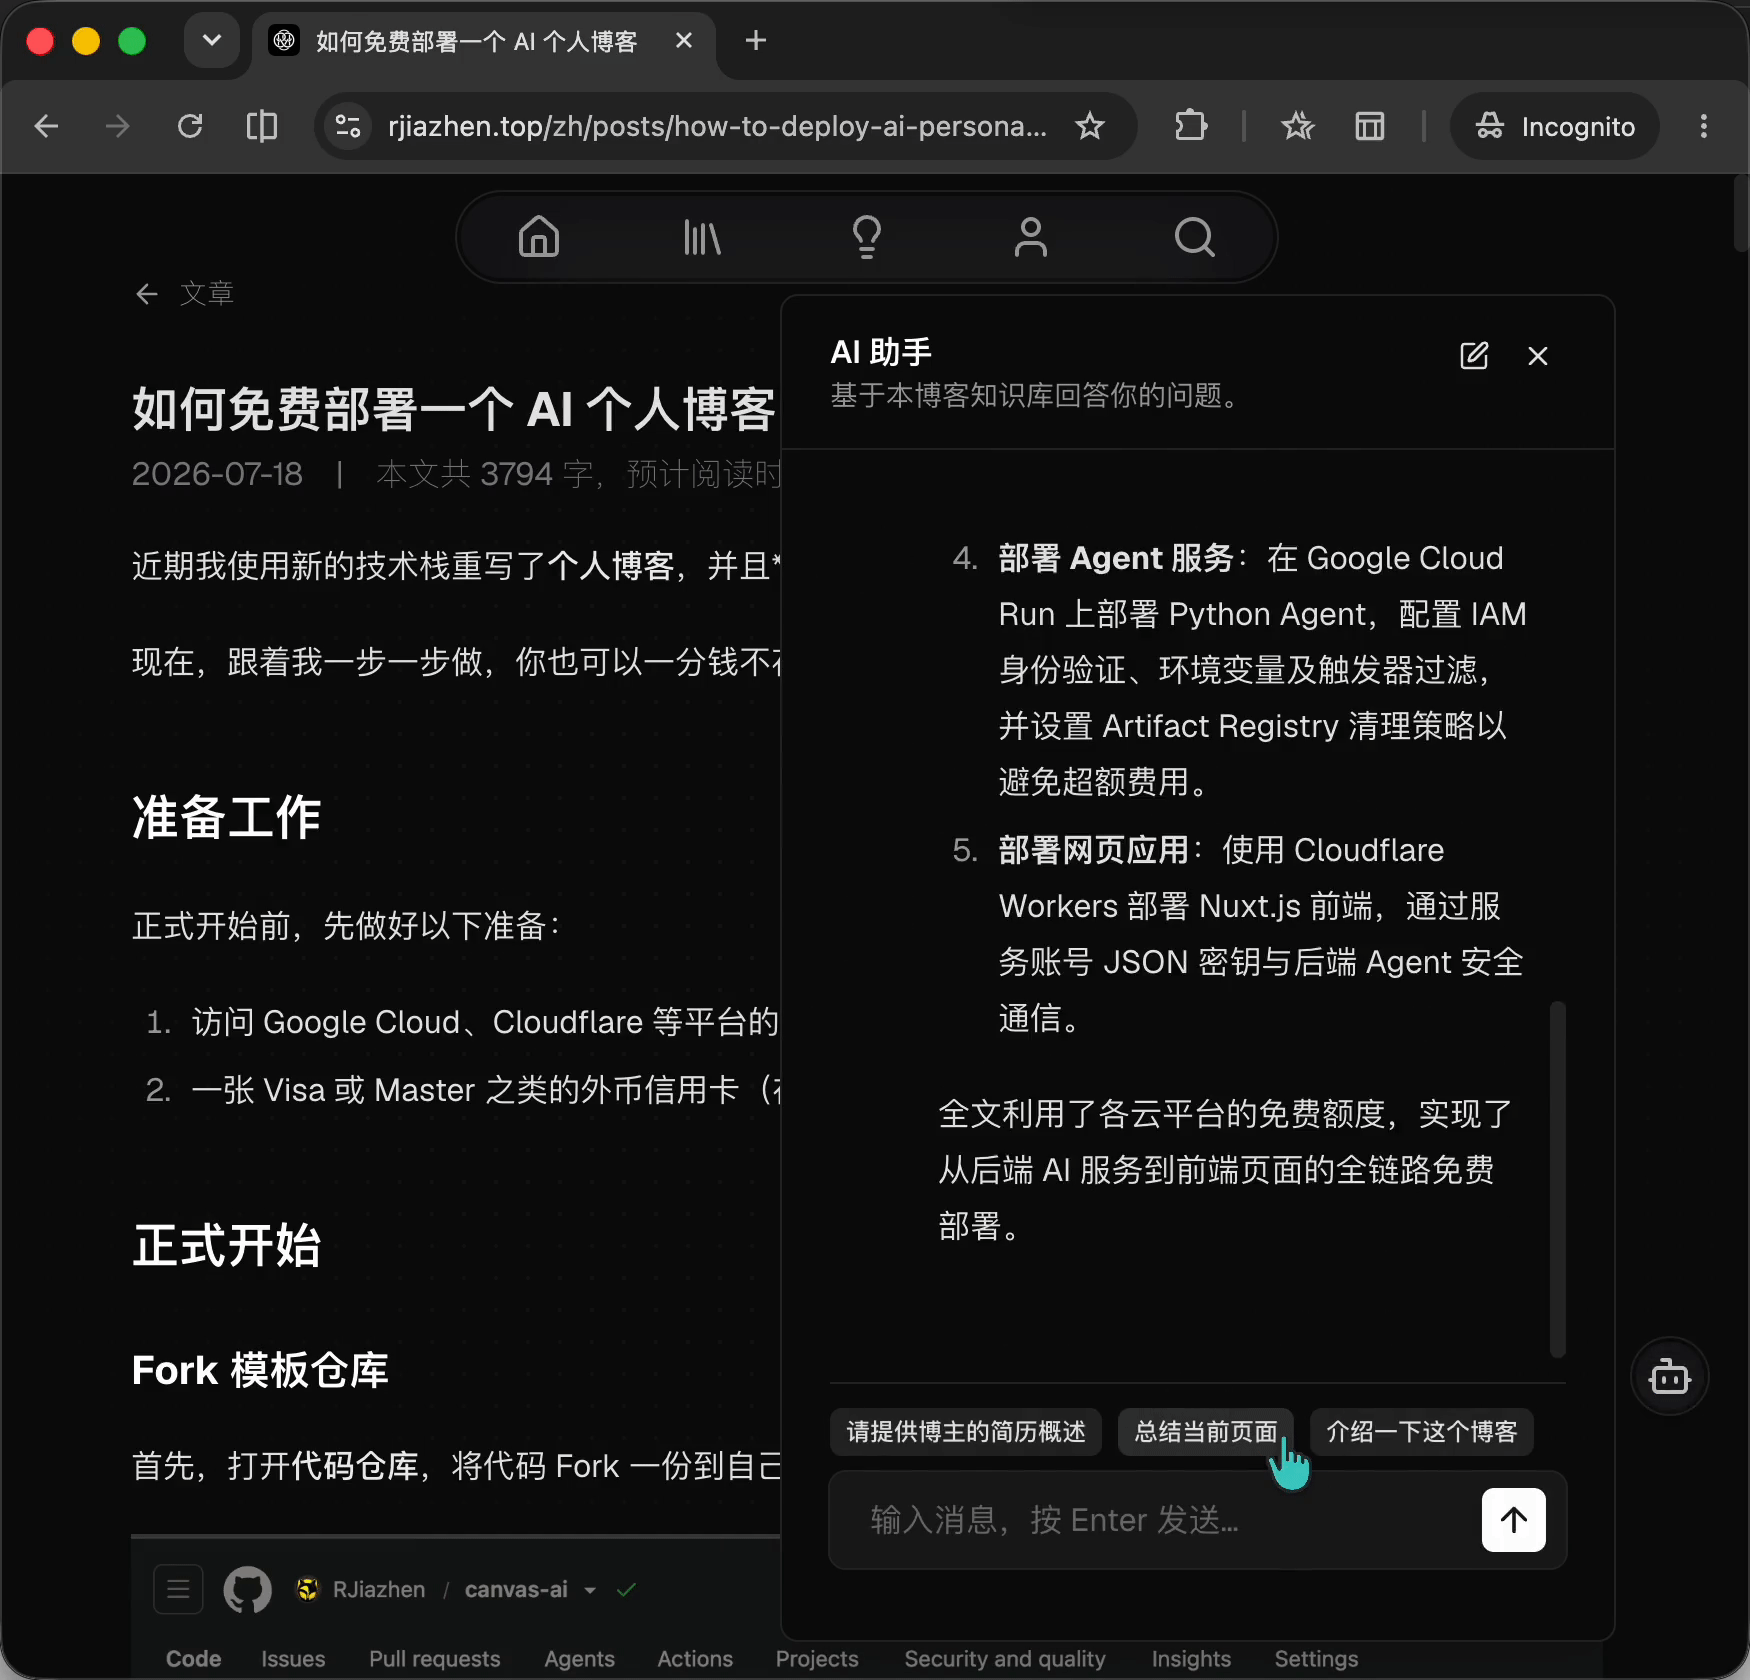
技术选型
首先总览一下技术选型:
| 主要技术 | |
|---|---|
| note(内容仓库) | 内容形式:Markdown; 同步和备份平台:GitHub; 同步到 web app:GitHub Actions。 |
| web app | 全栈框架:Nuxt.js; 内容站点插件:Nuxt Content; AI 能力支持:AI SDK |
| agent | 后端框架:FastAPI; Agent 框架:LangChain; 模型供应商:百炼 DashScope。 |
| Neon 数据库 | PostgreSQL、pgvector(向量数据库支持) |
内容与前端
首先,内容管理方面,我从两年前转为 VitePress 时,就已经是直接使用 GitHub 仓库管理笔记了,所以这次也不希望变动,维持原有方案。这样的优势很明显:笔记本身不受限于任何技术框架,甚至可以脱离 Obsidian、GitHub,变成一个纯本地的笔记目录。唯一的缺点是需要配置 CI/CD,才能把内容同步到网页应用中(具体同步配置会在下文说明)。
然后是前端框架。我在去年就调研过现有的 SSR 框架,并且写了一篇文章,当时就已经决定以后以 SSR 框架为学习重点,所以这次也直接走这条路。现有的 SSR 框架基本只有两个选择——Nuxt.js 和 Next.js;我个人相比 React 更喜欢 Vue,所以理所应当选了 Nuxt.js。同时,Nuxt.js 生态里也有针对内容站点的框架——Nuxt Content,可以基于 Markdown 生成页面内容(还提供了官方模板)。
所以,我直接以 Nuxt Content 为基础,并用一套官方模板起步。当然,这个选择也给后续诸多问题埋下了伏笔。
AI 后端和数据库
而在 AI 方面,首先是大模型。供应商直接选了阿里的百炼平台,因为还有大量免费额度没用完,正好现在用上。LLM 选的是 qwen3.6-max:当前博客并不需要深度思考之类的能力,所以选了这个支持关闭思考模式、同时响应速度够快的模型。向量模型则选了 qwen3.7-text-embedding。
Agent 方面选了 LangChain 这个很常见的开发框架,以及配套的 Agent 调试 SDK LangSmith;但没有直接集成在 Nuxt 应用里,而是在同一 monorepo 中单独放了一个 Python 的 agent 应用(使用 LangChain 的 Python SDK),并单独部署到 Cloud Run。至于为什么不集成在 Nuxt 里,以及为什么不用 Cloudflare 的 Agent 开发全家桶,下文都会详细说明。
数据库则直接用了 Neon 的 PostgreSQL;向量能力也按 Neon 官方文档,用 pgvector 插件实现。
应用运行架构
整个应用遵循内容与应用解耦:内容仓库(note)独立,应用仓库通过 submodule 引用 note,不把 Markdown 复制进 web app 的 content/。
同时,Agent 服务由单独的应用(agent)负责;web app 通过 API 调用 agent,实现用户与 AI 的对话。
接下来是整个应用的运行架构:
flowchart LR
  subgraph content["内容仓库(note)"]
    MD["Markdown 文章与想法"]
  end

  subgraph nuxt["Nuxt.js 应用(web app)"]
    SITE["SSR 站点 · 内容渲染 · AiChat"]
  end

  subgraph ai["AI 应用(agent)"]
    AGENT["Agent 服务 · 向量检索 · 对话"]
  end

  NEON[("Neon 数据库<br/>pgvector · checkpoint")]

  content -->|"内容同步(CICD)"| nuxt
  nuxt -->|"知识库同步(CICD)"| ai
  nuxt <-->|"对话代理"| ai
  ai --> NEON
对话请求时序
读者在任意页面打开浮动 AiChat 发问时,浏览器只访问同源 /api/ai-agent/chat;Nuxt 后端收到请求后,再代为请求部署在 Cloud Run 上的 agent 应用的 /api/chat,并把上游 OpenAI 兼容 SSE 转成 AI SDK UI Message Stream 回给前端。多轮对话靠响应里的 threadId 与 Neon 上的 LangGraph checkpoint 衔接。
sequenceDiagram
  autonumber
  actor User as 读者
  participant AiChat as AiChat(浏览器 · AI SDK)
  participant NuxtBackend as Nuxt 后端<br/>POST /api/ai-agent/chat
  participant CloudRun as Cloud Run<br/>FastAPI POST /api/chat
  participant Agent as LangChain Agent
  participant Neon as Neon<br/>pgvector · checkpoint
  participant LLM as 百炼 DashScope

  User->>AiChat: 输入问题并发送
  Note over AiChat: 附带 threadId(多轮)<br/>与当前页 pageUrl(context)
  AiChat->>NuxtBackend: POST message · threadId · context.pageUrl
  NuxtBackend->>NuxtBackend: resolveAiAgentRequestClient<br/>线上注入 Cloud Run ID Token
  NuxtBackend->>CloudRun: POST /api/chat(Accept: text/event-stream)
  CloudRun->>Agent: stream_chat(message, threadId, context)
  Agent->>Neon: 读取 checkpoint(会话历史)

  opt Agent 判定需检索博客
    Agent->>Agent: retrieve_context(query)
    Agent->>Neon: pgvector 相似检索
    Neon-->>Agent: 相关文章片段
  end

  opt 问题与当前页面相关
    Agent->>Agent: get_current_page_info()
    Agent->>Neon: 按 path 拼接已入库正文
    Neon-->>Agent: 页面 chunks
  end

  Agent->>LLM: ChatOpenAI 流式补全
  LLM-->>Agent: token 流
  Agent->>Neon: checkpoint 持久化(run 结束)
  loop OpenAI 兼容 SSE
    Agent-->>CloudRun: data: chat.completion.chunk
    CloudRun-->>NuxtBackend: text/event-stream
    NuxtBackend-->>AiChat: UI Message Stream<br/>message-metadata · text-delta
    AiChat-->>User: 逐字渲染助手回复
  end
  CloudRun-->>NuxtBackend: data: [DONE]
  AiChat->>AiChat: localStorage 保存 threadId 与消息
CICD
为了实现以上的用户和 AI 交流文章内容的功能,需要进行以下几个方面的同步:
内容仓库与子模块同步
文章源与应用代码分仓管理:我在 note 仓库里写稿、push;应用侧是一个 monorepo,里面同时放 web app 与 agent,通过 submodule 引用 note,不复制 Markdown 到 web app 的 content/。
同步方式:
- 向 note
push后,note 侧 workflowupdate-nuxt-content-submodule自动运行。 - 在 GitHub Action 环境中拉取 monorepo,并执行
git submodule update --init --remote external/note,把子模块指针推进到 note 最新main。 - 若指针有变,向 monorepo
push变更。 - monorepo
main合并后, Cloudflare Workers Builds 会自动拉取代码(含 submodule)构建部署 web app;生产构建再触发知识库同步到 agent。
monorepo 另有一条可手动触发的子模块 bump workflow(workflow_dispatch),用于不经过 note push、直接在应用侧 bump 子模块的场景。
flowchart LR
  note["note<br/>push 内容更新"]
  gha["GitHub Actions<br/>拉取 monorepo<br/>更新 submodule"]
  mono["monorepo<br/>push 子模块指针变更"]
  hook["GitHub webhook"]
  cf["Cloudflare Workers Builds<br/>重新部署 web app"]

  note --> gha --> mono --> hook --> cf
知识库同步:文章新增与变更
以上流程只是内容到网页应用的数据流,而内容相关的向量库则是使用 Neon 进行管理,需要单独进行同步。
对此,生产构建在 Nuxt Content content:file:afterParse 批处理结束时,由 open-notes-knowledge-sync 模块(apps/web/modules/open-notes-knowledge-sync/syncBatch.ts)把本批已发布的 open_notes 文章与 agent 向量库对齐。核心逻辑是比对 MD5,避免每次全量重 embed:
- 拉取远端摘要:调用 agent
GET /api/knowledge/documents/metadata,得到各文章 path 对应的contentMd5(入库时由 agent 对 Markdown 正文计算的 MD5 hex)。 - 计算本地摘要:对本批每篇已发布文章的正文调用
computeKnowledgeArticleContentMd5,得到exportMd5。 - 逐篇比对:
- 向量库中没有该 path(
dbMd5 === undefined)→ 新增,POST /api/knowledge/documents批量写入; - path 已存在但
exportMd5 !== dbMd5(含contentMd5为空的历史数据)→ 变更,PUT /api/knowledge/documents按 path 全量替换; - 两者一致 → 跳过,不重复 embed。
- 向量库中没有该 path(
- agent 侧更新实现(
document_service.update_article):先按 path 删除该文所有 chunk,再对更新后的 Markdown 重新分块,经 LangChainPGVectorStore.aadd_documents调用 DashScope embedding 并写回 Neon;分块、向量化、落库均由 LangChain API 串联完成。新增走同一套aadd_documents流程,只是无需先删。
PR 预览与非 main 生产构建默认不跑知识库同步(shouldSyncOpenNoteWithKnowledge),避免预览环境污染线上向量库。
完整 CICD 流程
flowchart TB
  note["note push<br/>内容更新"]
  gha["GitHub Actions<br/>拉取 monorepo · 更新 submodule"]
  mono["monorepo push<br/>main"]
  hook["GitHub webhook<br/>push 事件"]

  note --> gha --> mono --> hook

  hook --> build
  hook --> gcpFilt

  subgraph build["web app 部署(Cloudflare Workers Builds)"]
    direction TB
    startDeploy(["开始部署"])
    cf["构建并部署 SSR"]
    md5["比对全部已发布文章 MD5<br/>与 agent 向量库摘要"]
    decide{"有新增或变更?"}
    api["调用 agent<br/>POST / PUT /api/knowledge/documents"]
    done["跳过 · 不重复 embed"]
    neon[("Neon · pgvector")]
    endDeploy(["部署完成"])

    startDeploy --> cf --> md5 --> decide
    decide -->|是| api --> neon --> endDeploy
    decide -->|否| done --> endDeploy
  end

  subgraph agentBuild["agent 部署(Google Cloud)"]
    gcpFilt{"Cloud Build 触发器<br/>Included files = apps/ai-agent/**?"}
    dockerBuild["Docker build"]
    dockerPush["Push 镜像到 Artifact Registry"]
    cloudRun["更新 Cloud Run 服务"]
    skip["跳过 agent 部署"]

    gcpFilt -->|匹配| dockerBuild --> dockerPush --> cloudRun
    gcpFilt -->|不匹配| skip
  end
选择这样的架构的原因
- 内容与应用解耦:写作仓库(note)独立,monorepo 只跟踪 submodule commit;草稿与 clippings 不进索引。
- web app 与 agent 同仓:Nuxt 与 FastAPI 分属
apps/web、apps/ai-agent,共享一套 CI/文档与本地调试入口,部署仍各走 Cloudflare / Cloud Run。 - 内容链路在迁移中复用:VitePress → Nuxt Content 只换 web app 实现,内容仍只在 note 维护,submodule 与
update-nuxt-content-submodule无需重写,降低迁移风险。 - 保留 Vue 技术栈与 Markdown 体验:Nuxt Content 的 collection + hook 能承接 VitePress/Obsidian 习惯(正文
#标题、status、date)。 - AI 能力外置:避免 Nuxt 入口与 Cloudflare Agents 模型冲突;Python 生态更适合 LangChain / pgvector / 后续实验。
- 部署各取所长:静态与 SSR 边缘节点用 Cloudflare;有状态 Postgres 与长连接 agent 用 Neon + Cloud Run。
本地开发与 Agent 协作
除了线上应用用 AI 优化用户体验,本地开发里也大量用 AI 辅助开发。
应用 monorepo(内含 web app、agent)配了一套方便 AI Agent 参与开发的环境,目标是把「读代码」扩展到「读运行态页面、控制台、OpenAPI、线上日志」。
一键启动与浏览器调试
首先是本地开发里配好的快捷启动与浏览器调试:
- web app:VS Code F5(
Web: Nuxt)先跑pnpm dev,再打开带--remote-debugging-port=9222的隔离 Chrome;工作区.cursor/mcp.json挂上 chrome-devtools MCP,Agent 能直接操作开发页、读 DOM 快照和调试控制台。 - agent:调试启动后由 launch 的
serverReadyAction自动打开 Swagger 文档页(/docs),方便点 REST 接口做联调;也可与 web app 用 compoundWeb + AI Agent一并启动。
Hey API 客户端 codegen
web app 通过 Hey API(@hey-api/openapi-ts)在 predev / prebuild 等阶段,从 localhost:8080(生产构建则读线上 Cloud Run 地址)拉 /openapi.json,生成接口方法与类型(apps/web/scripts/generate-ai-agent-api.mjs、apps/web/app/api/ai-agent/)。本地与 CI 共用同一套流程,避免手写 fetch 路径与请求体类型。
Cursor Plugin、MCP、Skills 与运维工具链
以上还只是开发侧支持;从开发完成到线上部署,还需要运维侧的配套。
所以本项目基于 Cursor 的 MCP、插件、Skills,为 web app 与 agent 接上相关 MCP 或官方集成,并补了运维用的 Skills 与 CLI 工具链。
包括:
- 通过 Cloudflare 插件让 Agent 访问 Cloudflare 的运行与部署日志,诊断线上问题,并完成优化与重新部署,直到问题解决;
- 通过 Neon 插件让 Agent 直接查询 Neon 中的数据,排查数据库问题;
- 配置 Nuxt UI MCP,方便 Agent 查组件文档并生成 Nuxt UI 相关代码;
- 配置 Chrome DevTools MCP,让 Agent 操作开发页、读 DOM 快照和调试控制台;
- 官方没有 MCP 或配套 Agent 工具时,则安装对应 CLI,并配置 Skills,让 Agent 用 CLI + Skills 做运维,例如:
- 用 GitHub CLI 访问 GitHub 仓库,检查 GitHub Actions 运行状态,以及提交、创建 PR;
- 用 Google Cloud CLI 访问 Cloud Run 项目日志,自动诊断问题、检查账单等;
项目规则、Skills 配置
除了上述现成工具,针对本项目也配了专门的规则与 Skills,包括:
- Rules
- 核心规则:项目上下文、文档与规则维护、官方框架文档优先、代码结构简洁、依赖克制、全局注释规范、Plan 模式须先出可审核设计方案等,用来稳住后续开发与维护秩序;
- web app 相关规则:Nuxt UI 优先、Nuxt Content 解析 Hook、
shared/utils放置约定、Vue SFC 组件文档与 props 提示等,专门约束 web app; - 语言规范:TS/JS 一律 JSDoc、变量与参数须用有意义的名词命名等,约束风格、格式与命名,抬高生成代码质量;
- 架构相关:改 GitHub Actions /
wrangler.jsonc时对齐 CI/CD 与 Cloudflare 文档,以及对齐 Google Cloud 的文档,让 Agent 清楚当前项目的架构与运行方式;
- Skills
- 研发流程:
continue——从 issue 开分支,到提交、开 PR、合并的分阶段推进;一个 skill 卡住关键节点,方便人随时介入,降低 Agent 行为越界的风险; - 本地与线上调试:本地 Workers + wrangler preview、Cloud Run 本地代理打线上 API、gcloud 排查构建/部署/运行日志,以及对齐 Cloudflare 的文档,让 Agent 清楚本地与线上调试方式;
- UI 与测试:Nuxt UI 组件选型与布局配方、沙箱环境下 Playwright E2E 的浏览器路径与权限处理,以及对齐 Vue 的文档,让 Agent 清楚当前项目的 UI 与测试方式;
- 研发流程:
总结
作为个人博客开发日志的第一篇,本文主要介绍整个项目的主要架构。具体设计细节,以及开发过程中的踩坑与反思,敬请期待后续更新。